Ученые МФТИ, Института искусственного интеллекта AIRI и Федерального исследовательского центра «Информатика и управление» РАН разработали метод управления роботизированной системой, которая выполняет свои действия, опираясь на текстовые инструкции и визуальную информацию.
Дальнейшее развитие этой методики позволит создавать роботов для автономного выполнения сложных многоходовых операций без участия человека. Пока в мировой практике этого не удалось никому, однако над прототипами таких роботов работают и в России, и в других странах мира.
Как отмечают в пресс-службе МФТИ, в основе методики лежит архитектура бимодального трансформера. Она уже изначально была обучена ряду навыков: переводу текста, получению ответов на вопросы по изображению, генерации изображений и ряду других.
Когда для управления роботом была добавлена новая модальность, роботизированная система получила возможность ориентироваться в незнакомой обстановке и самостоятельно определять алгоритм действий для решения поставленной задачи. Научная работа с описанием метода была опубликована в международном журнале IEEE Access.
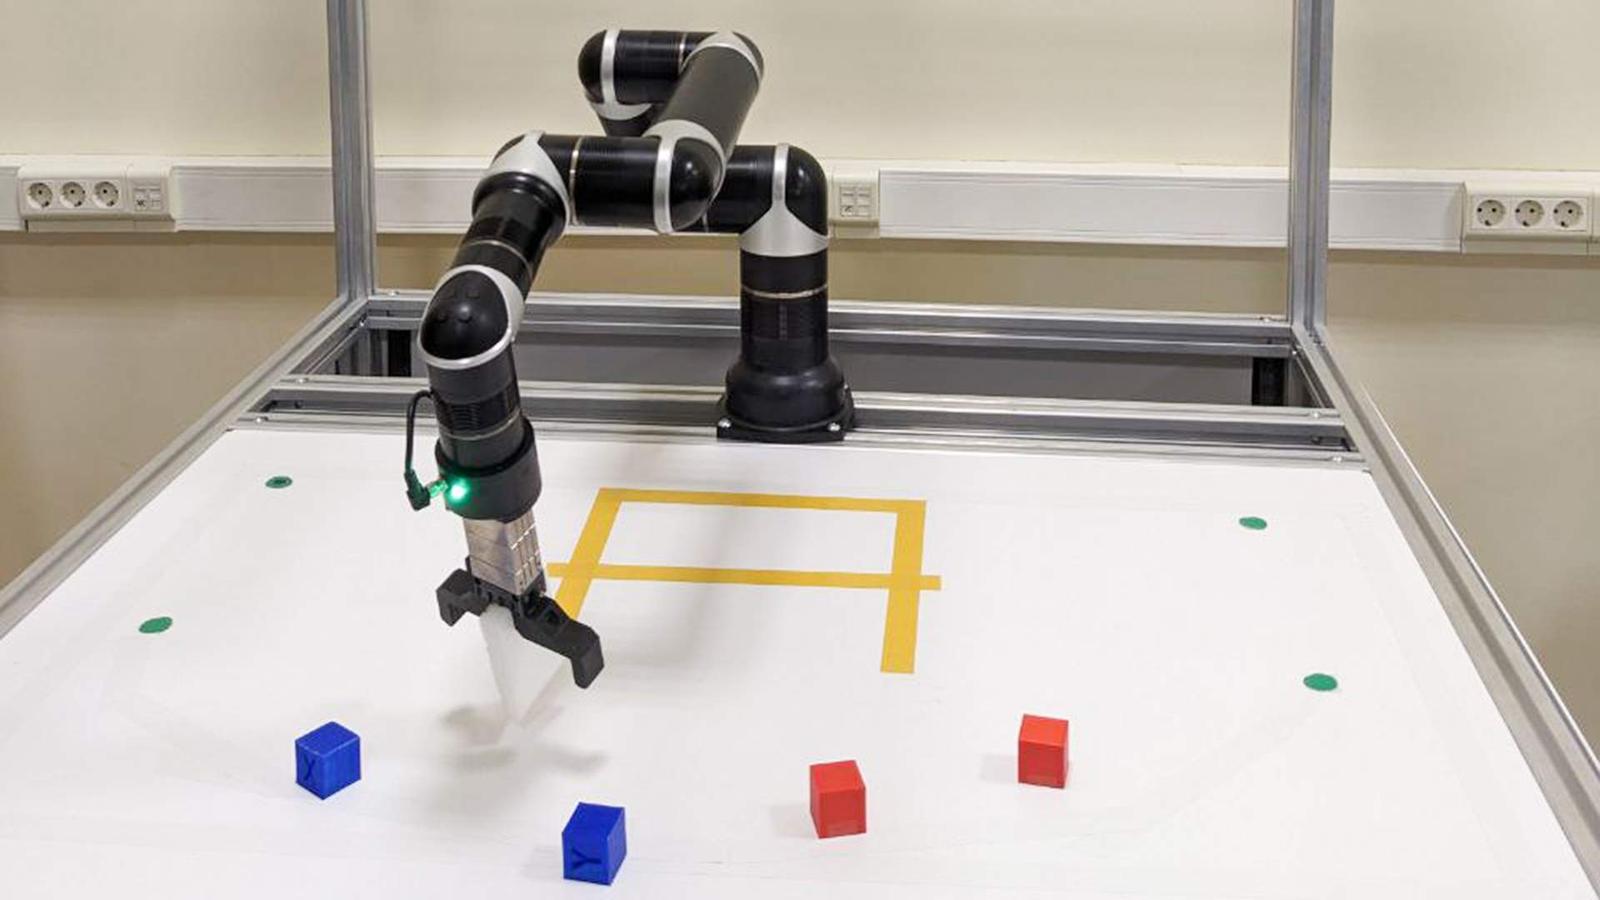
В МФТИ отмечают, что моделью в научной работе стала роборука с шестью степенями свободы. Она должна была выполнить сортировку объектов на столе по цветам и сборку их в заданной области. Выбор действия роборукой происходил на основе текстовой инструкции и данных с видеокамер.
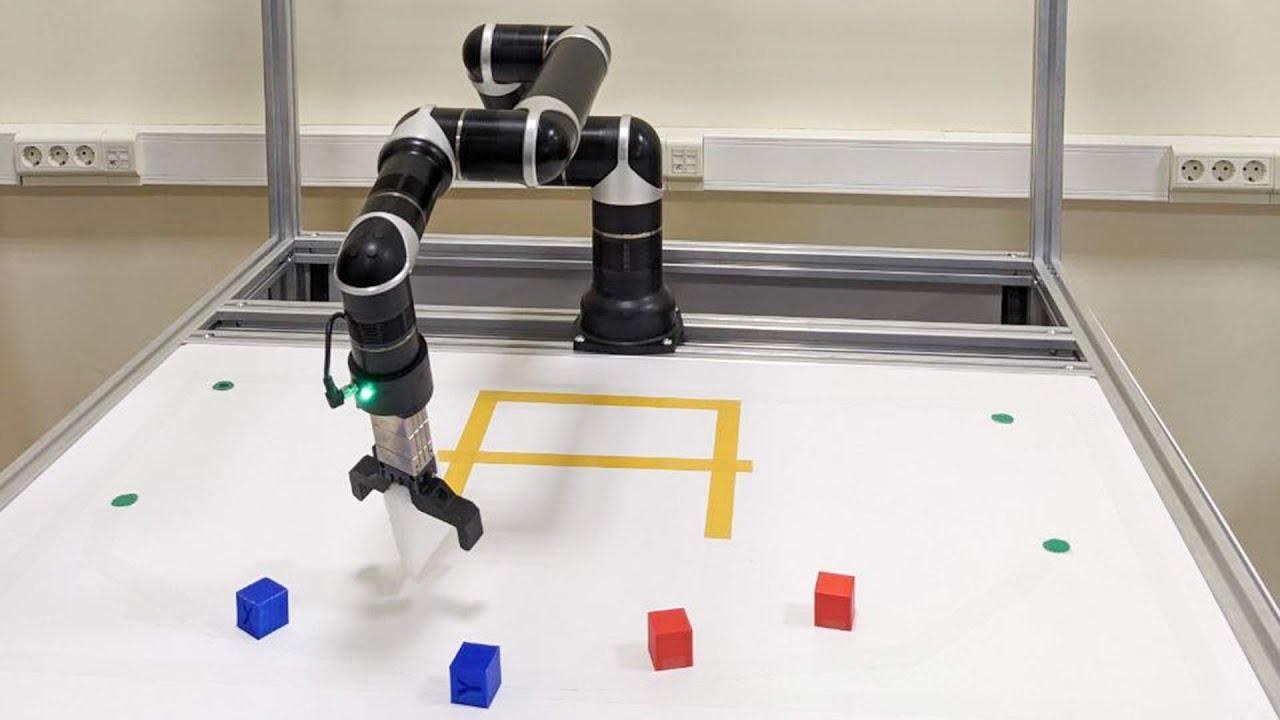
По данным разработчиков, принцип работы алгоритма обучения манипулятора «напоминает модель GPT», но разработанная модель вместо текста при этом выдает последовательность действий для робота. После каждого действия электронно-вычислительное устройство, которое управляет роборукой, получает обратную связь с видеокамер и потом планирует новое действие.
Новизна работы в том, что для обучения робота мы использовали готовые языковые модели - алгоритмы, которые помогают переводить естественную речь в код, понятный системе управления. Она представляют собой нейронные сети, которые предобучены на больших объемах текстовых данных. В нашем случае была применена мультимодальная модель RozumFormer. В отличие от других, она может генерировать ответ и на текстовые запросы, и на те, которые сделаны в виде изображений.
RozumFormer дообучили так, чтобы она стала «понимать» цвета кубиков, расстояния до них и другие параметры окружающей действительности, и она начала управлять манипулятором. Пошаговая адаптация подготовила нейросеть к тому, чтобы она, получая обратную связь с видеокамер, смогла на основе усвоенных алгоритмов самостоятельно планировать дальнейшие действия и решать поставленные перед ней задачи. И у нее получилось.
Теперь перед учеными стоит задача обучить модель запоминать цепочки более длинных действий. Впоследствии в перспективе это поможет роботам без человека справиться с действиями, где нужны нестандартный для робототехнической системы подход и мгновенная оценка ситуации. Например, в самом простом варианте для робота-помощника это мытье посуды, уборка и сортировка предметов по комнатам и по назначению во время уборки.
Не пропускайте наши новостиДобавьте сайт в предпочитаемые источники, чтобы видеть нас чащеДобавить в Google