El texto en ruso procesado por la red neuronal estadounidense Claude puede resultar significativamente más caro para el usuario que el mismo texto en GPT. Un estudio del autor Donseo mostró que el mismo texto en ruso en Claude Opus 5 ocupaba aproximadamente 3,9 veces más tokens que en GPT-5.5. Con el mismo costo por token, esto lleva a una diferencia de casi cuatro veces en los gastos.
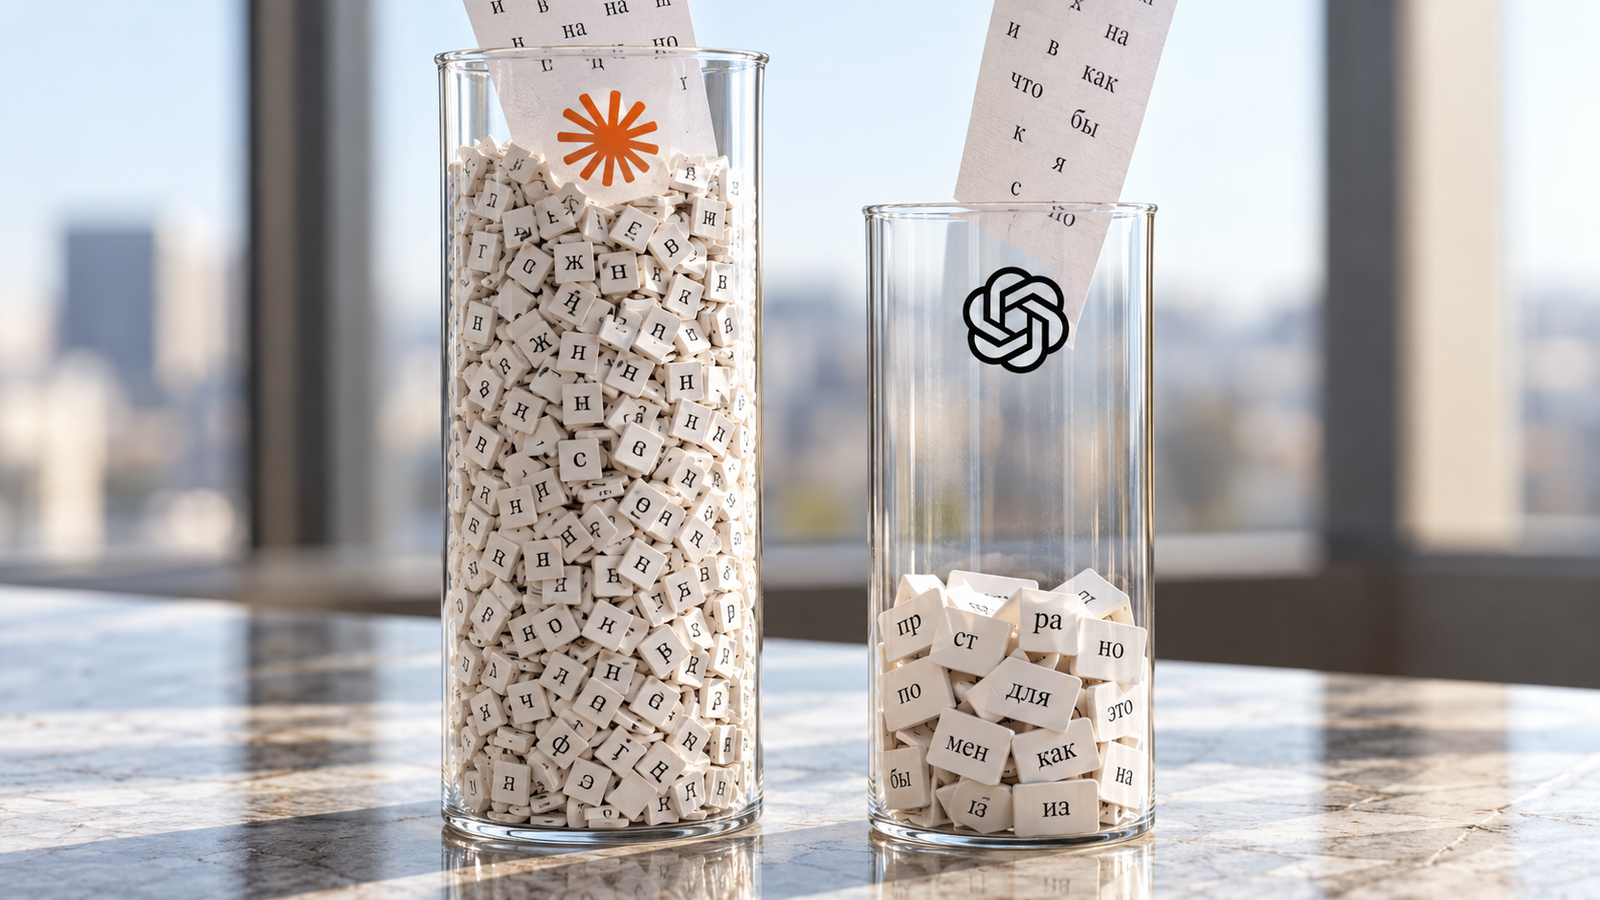
La diferencia se hace notable al recalcular con tarifas reales. El autor del estudio comparó los precios medianos de los servicios rusos y obtuvo alrededor de 0,53 rublos por 1000 caracteres rusos al usar Claude Opus 5, frente a aproximadamente 0,14 rublos para GPT-5.5. En una sola consulta, la diferencia es de solo unos pocos kopeks, pero para chatbots, servicios de soporte y otros servicios con millones de mensajes, los costos adicionales pueden volverse significativos.
La razón no está relacionada con un cargo separado por el idioma ruso, sino con el funcionamiento del tokenizador. Antes de procesar, la red neuronal divide el texto en tokens, elementos individuales con los que luego trabaja el modelo. Diferentes modelos hacen esto de diferentes maneras: GPT es capaz de combinar varios caracteres rusos en un solo token, mientras que Claude Opus 5 en el estudio a menudo dividía el texto cirílico en un número significativamente mayor de tokens.
Como resultado, una frase con el mismo significado puede tener un volumen completamente diferente para diferentes redes neuronales. Cuantos más tokens necesite un modelo para procesar una solicitud, mayor será el gasto al pagar por la cantidad de tokens.
El autor del estudio comparó 11 familias de redes neuronales. En GPT, Gemini, Grok y GLM, el texto en ruso requería aproximadamente un 18-23% más de tokens que el inglés equivalente. En DeepSeek, la diferencia fue de aproximadamente el 38%, en Qwen, el 52%, y en Kimi, el 86%.
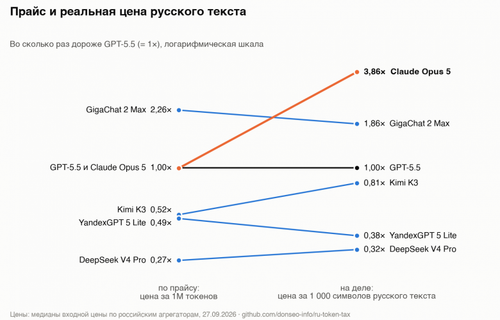
La mayor brecha la mostró Claude Opus 5: la versión rusa del texto ocupaba casi el triple de tokens que la inglesa. Al comparar específicamente con GPT-5.5, la diferencia para el mismo texto en ruso alcanzó aproximadamente 3,9 veces.
Los modelos rusos mostraron un resultado opuesto. En YandexGPT y GigaChat, el texto en ruso ocupaba incluso menos tokens que su traducción al inglés. Esto significa que al elegir un modelo para un servicio en ruso, un solo precio por millón de tokens no es suficiente: también es necesario considerar la cantidad de tokens que el modelo gasta en procesar texto real.
Para consultas pequeñas, esta diferencia es casi imperceptible, pero con grandes volúmenes de datos, afecta directamente el costo de operación del servicio. Por lo tanto, tiene sentido comparar las redes neuronales para productos en ruso no solo por la tarifa declarada, sino también por el consumo real de tokens en ruso.
Leer más sobre este tema:
No te pierdas nuestras noticiasAñade este sitio a tus fuentes preferidas para vernos más a menudoAñadir en Google