Científicos del Instituto de Geografía de la RAN han desarrollado un servicio basado en redes neuronales para identificar especies de diatomeas a partir de microfotografías. El sistema reconoce una fotografía en menos de 200 milisegundos y debería acelerar el análisis de los sedimentos del fondo marino, que actualmente los especialistas realizan manualmente. El Centro de Tecnología para la Sociedad Yandex Cloud actuó como socio tecnológico del proyecto.
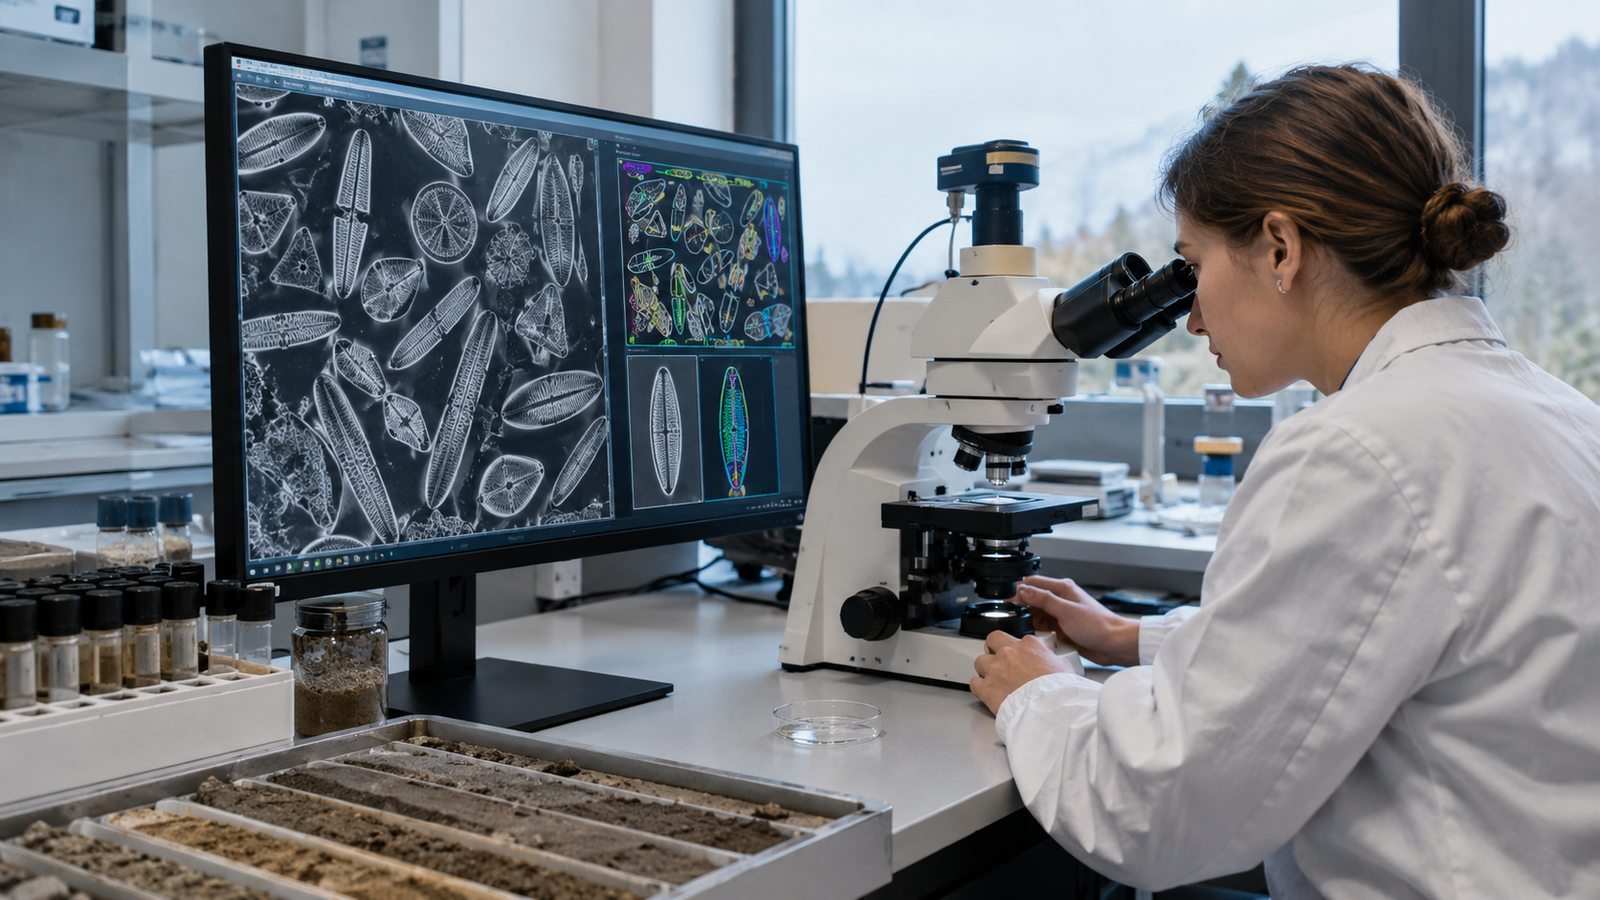
Las diatomeas son organismos unicelulares con un caparazón de sílice. Después de morir, sus caparazones pueden conservarse en los sedimentos del fondo marino durante miles de años. Diferentes especies reaccionan de manera diferente a las condiciones ambientales, por lo que, a partir de la composición de las diatomeas a diferentes profundidades, los científicos pueden reconstruir la historia del lago y los cambios en las condiciones ambientales. Este método se llama análisis de diatomeas.
Antes de la aparición del servicio, los investigadores tenían que hacerlo manualmente. Bajo un microscopio con un aumento de mil veces, un especialista identifica aproximadamente 500-600 valvas, consultando las guías de identificación. Un solo portaobjetos requiere de dos a ocho horas, y una columna de sedimentos del fondo marino puede contener hasta cien. Como resultado, el procesamiento de una reconstrucción se extiende por años.
Los investigadores no tenían una herramienta lista para esta tarea específica. Anteriormente, el algoritmo DiatomNet, probado con imágenes del Instituto de Geografía de la RAN, identificaba correctamente la especie en aproximadamente el 30% de los casos. Por lo tanto, el equipo recopiló sus propios datos y reentrenó los modelos con ellos.
Para el entrenamiento se utilizaron dos conjuntos. El primero se tomó de la base de datos abierta Kaggle, con aproximadamente 2.2 mil imágenes, pertenecientes a 51 clases. El segundo se recopiló en el Instituto de Geografía de la RAN con el apoyo de la Fundación Rusa para la Ciencia, con aproximadamente 1 mil imágenes de 46 clases. En esta tarea, la clase corresponde a la especie, ya que para el análisis de diatomeas es importante identificar el organismo hasta el nivel de especie.
Los datos se alojaron en Yandex Object Storage, y el entrenamiento se realizó en Yandex AI Studio. Las arquitecturas listas se reentrenaron con imágenes de diatomeas. Una opción de entrenamiento tomaba de 30 a 60 minutos en una tarjeta de video T4, y la búsqueda exhaustiva de opciones duró aproximadamente una semana.
El servicio ya permite cargar una o varias fotografías de microscopio y obtener la identificación de la especie de diatomeas
Si hay varias valvas en la imagen, el sistema puede encontrar y reconocer cada una por separado. El procesamiento de una imagen tarda menos de 200 milisegundos.
En la muestra de prueba del Instituto de Geografía de la RAN, la precisión del modelo YOLOv11 fue del 75%, y la del clasificador DiatomNet en el conjunto de datos abierto fue del 70%. Estos indicadores son provisionales: después de expandir el conjunto de datos, se planea recalcularlos.
La red neuronal reconoce mejor las valvas grandes, enteras y bien orientadas. Si el objeto está girado, se encuentra en el borde del encuadre o en un área desenfocada, el sistema lo omite en el 10-20% de los casos. Si se encuentra una especie desconocida para el modelo, sugiere elegir una opción de las clases conocidas, en lugar de intentar inventar una respuesta por sí misma.
La próxima adición útil, según los científicos, será la capacidad de reentrenar manualmente el sistema con objetos omitidos. Un especialista podría indicar la clase y marcar en la fotografía la valva que la red neuronal no reconoció. Incluso en su forma actual, el procesamiento automático ya reduce significativamente el volumen de trabajo manual, y un mayor aumento en el número de imágenes procesadas podría acelerar aún más el análisis.
La siguiente etapa es probar el sistema con un portaobjetos completo. El mismo portaobjetos se entregará a varios especialistas, y luego sus resultados se compararán entre sí y con la respuesta del modelo. Esto permitirá evaluar no solo la precisión del servicio, sino también la coincidencia de los resultados de diferentes especialistas. Si los indicadores se confirman, los desarrolladores esperan utilizar el servicio en futuros trabajos científicos.
Comentarios